ConfigMap이랑 Secret, 왜 이렇게 따로 나눠놨을까
ConfigMap과 Secret이 왜 두 개의 API로 쪼개져 있는지, env로 넣은 값은 왜 재시작 전엔 안 바뀌는지 하나씩 파본 기록
Kubernetes 매니페스트를 쓰다 보면 다들 한 번쯤 이런 의문이 든다. ConfigMap이랑 Secret, 그냥 하나로 합쳐도 될 것 같은데 왜 굳이 API를 나눠놨을까. 그리고 env로 넣은 값은 Pod를 재시작해야만 바뀌는데, 왜 볼륨으로 마운트한 값은 재시작 없이 자동으로 갱신될까. 사소해 보이지만 파고들면 파고들수록 쿠버네티스 설계 철학이랑 리눅스 프로세스 모델까지 이어지는 재밌는 질문이라 한번 정리해봤다.
1. ConfigMap이랑 Secret은 뭐가 다른가
ConfigMap이랑 Secret은 컨테이너 이미지에서 설정을 분리하기 위해 만들어진 오브젝트다. 12-Factor App에서 말하는 설정은 환경변수나 저장소에 커밋되지 않는 파일에 저장한다는 원칙을 쿠버네티스식으로 구현한 결과라고 보면 된다.
ConfigMap은 민감하지 않은 Key-Value 설정을 담는다. 로깅 레벨, 외부 서비스 엔드포인트, 기능 플래그 같은 것들이다. 볼륨/ENV/커맨드라인으로 Pod에 흘려 넣을 수 있는데, 1MiB를 넘는 데이터는 애초에 담을 수 없게 설계돼 있다. 그 이상이면 볼륨 마운트나 별도 DB/파일 서비스를 쓰라는 뜻이다.
Secret은 API Key, DB 패스워드, TLS 인증서, OAuth 토큰처럼 민감한 데이터를 위한 오브젝트다. 그런데 여기서 하나 짚고 가야 할 게 있다. Secret은 기본적으로 etcd에 평문으로 저장된다. 암호화되지 않은 채로 저장된다는 뜻이라 API 접근 권한이 있거나 etcd에 직접 접근할 수 있는 사람은 누구나 조회·수정이 가능하고, 심지어 특정 네임스페이스에 파드 생성 권한만 있어도 그 네임스페이스의 모든 Secret을 읽을 수 있다. 그래서 실무에서는 최소한 이 정도는 챙겨야 한다.
- Secret에 Encryption at Rest를 켠다.
- RBAC으로 Secret 접근 권한을 최소한으로 제한한다.
- 필요한 컨테이너에만 Secret을 노출한다.
- 가능하면 외부 Secret 저장소(Vault, AWS Secrets Manager 등) 연동을 고려한다.
Secret의 type도 종류가 여러 개인데, 가장 흔히 쓰는 Opaque 외에 ServiceAccount 토큰용 kubernetes.io/service-account-token, Private Registry 인증용 kubernetes.io/dockerconfigjson, TLS 인증서용 kubernetes.io/tls 등이 있다. data 필드는 반드시 base64로 인코딩된 문자열이어야 하고, stringData는 그 인코딩을 API Server가 대신해주는 쓰기 전용 필드다(조회하면 안 보이고 data 필드에 인코딩된 값만 남는다).
그럼 이 둘을 왜 별도 API로 쪼개놨을까. 크게 두 가지 이유가 있다고 본다.
첫 번째는 최소 권한이다. 만약 ConfigMap 하나에 민감한 값까지 다 들어간다면 노출하면 안 되는 값만 걸러서 접근 제어하기가 복잡해진다. 반대로 ConfigMap 자체를 다 잠가버리면 여러 팀·서비스가 공유해서 쓰기 어려워진다. 그래서 ConfigMap에는 아예 민감하지 않은 것만 담아 접근 제어를 걷어내고, Secret에만 RBAC을 걸어서 권한 경계를 명확하게 만든 것이다.
두 번째는 확장성이다. Secret을 별도 Kind로 정의해뒀기 때문에 HashiCorp Vault나 AWS Secrets Manager 같은 외부 시스템이 External Secrets Operator 같은 컨트롤러를 통해 Secret 객체만 정확히 타겟팅해서 연동할 수 있다. 그 덕에 동적 Secret 생성, 자동 순환, 중앙화된 감사처럼 쿠버네티스 네이티브 기능만으로는 어려운 고급 보안 기능까지 위임할 수 있게 된다.
2. Pod에 집어넣는 방법은 두 가지다
ConfigMap·Secret을 Container에 전달하는 방법은 크게 env와 볼륨 마운트, 두 가지다. 이 둘의 차이가 이 글의 진짜 시작점이다.
env로 주입하기. env나 envFrom 필드로 ConfigMap·Secret의 key-value를 컨테이너 환경 변수로 바로 매핑할 수 있다. 가장 간편한 방법이고, 대부분 애플리케이션은 코드 수정 없이 환경 변수를 읽기만 하면 된다.
# 예시: 특정 key를 선택하여 환경 변수로 주입
apiVersion: v1
kind: Pod
metadata:
  name: my-pod
spec:
  containers:
    - name: my-container
      image: redis
      env:
        - name: MY_ENV_VARIABLE
          valueFrom:
            configMapKeyRef:
              name: my-configmap
              key: my-key
그런데 이 방식은 Pod가 뜬 후에는 ConfigMap·Secret이 바뀌어도 절대 반영이 안 된다. 업데이트하려면 무조건 Pod를 재시작해야 한다. 게다가 환경 변수는 /proc/[pid]/environ 파일로 노출되기 때문에 같은 노드의 다른 프로세스나 권한 있는 사용자가 들여다볼 수 있어서 보안적으로도 살짝 아쉽다.
볼륨으로 마운트하기. ConfigMap·Secret을 정의해두고 volumeMounts로 컨테이너 내부 경로에 파일로 마운트하는 방식이다. key는 파일명이 되고 value는 파일 내용이 된다.
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: test-config
data:
  APP_NAME: "MyTestApp"
  DATABASE_HOST: "db.example.com"
  DATABASE_PORT: "5432"
  LOG_LEVEL: "INFO"
---
apiVersion: v1
kind: Pod
metadata:
  name: test-pod-volume-only
spec:
  containers:
    - name: main-container
      image: busybox
      command: ["sh", "-c", "sleep 3600"]
      volumeMounts:
        - name: config-volume
          mountPath: /etc/config
  volumes:
    - name: config-volume
      configMap:
        name: test-config
  restartPolicy: Never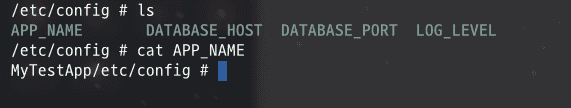
이 방식의 특징은 Hot Reload다. ConfigMap·Secret이 바뀌면 kubelet 동기화 주기에 맞춰 잠시 후 컨테이너 내 파일 내용이 Pod 재시작 없이 자동으로 갱신된다. 대신 애플리케이션이 파일 시스템에서 설정을 다시 읽도록 구현돼 있어야 하니, properties·conf·toml류 설정 파일에 특히 잘 맞는다.
여기서 궁금해지는 지점이 하나 생긴다. 왜 굳이 이렇게 성격이 다른 두 가지 방식을 다 지원할까? 결론부터 말하면 '예측 가능한 안정성(Immutability)'과 '운영상의 유연성(Dynamic Update)'이라는, 서로 다른 두 설계 목표를 동시에 만족시키기 위해서다.
env 방식은 컨테이너 시작 시점에 메모리에 박히는 불변 값이다. "설정이 바뀌면 Pod를 새로 배포한다"는 불변 인프라(Immutable Infrastructure) 철학을 강제해서, 런타임 중 설정이 슬쩍 바뀌어 생기는 예측 불가능한 오류를 원천 차단한다. 그 대신 Hot Reload는 포기해야 한다.
volumeMounts 방식은 반대로 kubelet이 원본 리소스 변경을 감지하면 마운트된 파일을 원자적으로 교체해준다. 그래서 애플리케이션이 파일 변경을 감지하기만 하면 Pod 재시작 없이 Hot Reload가 가능하다. 로깅 레벨 변경이나 기능 플래그 전환처럼 서비스 중단 없이 즉시 반영해야 하는 운영 요구를 만족시키기 위한 선택이다.
그런데 이 설명, 어디서 많이 본 것 같지 않은가. 사실 이건 쿠버네티스만의 특별한 정책이 아니라 리눅스 프로세스 모델 그 자체에서 오는 특성이다. 왜 그런지 하나씩 따라가보자.
3. env는 왜 재시작 전엔 절대 안 바뀔까
컨테이너도 OS 입장에서는 그냥 프로세스다. 그러니 새 프로세스가 만들어지는 원리를 그대로 따른다. 새 프로세스는 보통 fork()와 execve(), 이 두 시스템 콜로 만들어진다.
fork()를 호출하면 부모 프로세스는 자신과 똑같은 복제본인 자식 프로세스를 만든다. 이때 자식은 부모의 메모리, 파일 디스크립터, 환경 변수까지 그대로 물려받는다.execve()는 자식 프로세스가 자기 자신을 새로운 프로세스로 완전히 교체하는 시스템 콜이다. 이 함수를 부를 때 새 프로세스에 넘길 초기 환경 변수 목록을 인자로 함께 전달한다.
컨테이너가 시작될 때도 똑같은 흐름을 탄다.
- kubelet(부모 프로세스 역할)이 컨테이너 런타임에게 Pod Spec에 정의된 환경 변수 목록을 전달한다.
- 컨테이너 런타임은 이 정보를 받아 컨테이너 내부 메인 프로세스를
execve()로 실행하면서, 전달받은 환경 변수로 초기화한다.
kubelet이 실제로 이 값을 어디서 어떻게 가져오는지 조금 더 들어가보면 이렇다.
- 감시: 각 노드의 kubelet은 API Server를 계속 Watch하면서
spec.nodeName이 자기 노드인 Pod가 있는지 체크한다. - Pod 인지: 스케줄러가 Pod를 노드에 할당하면, kubelet은 API Server에서 해당 Pod 명세를 읽어 어떤 ConfigMap·Secret이 필요한지 파악한다.
- 데이터 Fetch: kubelet이 필요한 ConfigMap·Secret 객체를 API Server에 명시적으로 요청해서 가져온다. 이 통신은 TLS로 암호화되고, kubelet은 ServiceAccount나 인증서로 인증·인가를 받는다.
- 주입: env 방식이면 가져온 key-value를 메모리에 들고 있다가 CRI에 컨테이너 생성을 요청할 때 환경 변수로 같이 넘긴다. 컨테이너 런타임은 이걸 받아 첫 프로세스 실행 시 환경 변수로 설정한다.
여기까지 보면 답은 명확하다. 환경 변수는 execve()가 프로세스를 초기화하는 그 순간에 한 번 각인되고, 그 이후에는 OS가 실행 중인 프로세스의 환경 변수를 외부에서 바꿀 방법을 아예 제공하지 않는다. 프로세스도 마찬가지로 일단 실행되면 다른 프로세스로부터 격리된다. 만약 이게 가능했다면 임의의 프로세스가 다른 프로세스의 PATH나 DB_PASSWORD를 마음대로 바꿔치기할 수 있다는 뜻이 되니, 프로세스 격리 원칙을 지키려면 env는 불변일 수밖에 없다.
4. volumeMount는 어떻게 재시작 없이 갱신될까
반면 볼륨 마운트가 Hot Reload를 지원하는 이유는 파일 시스템 마운트라는 메커니즘 자체가 애초에 여러 프로세스 간 데이터 공유를 위해 설계됐기 때문이다. kubelet이 실제로 파일을 어떻게 배치하는지 보면 답이 나온다.
- kubelet은 호스트 노드의 특정 경로(
/var/lib/kubelet/pods/<pod-uid>/volumes/kubernetes.io~configmap/<volume-name>)에 디렉터리를 만든다. - 가져온 데이터의 key를 파일명으로, value를 파일 내용으로 써서 그 디렉터리에 파일을 생성한다.
..data라는 심볼릭 링크를 만들어 방금 만든 타임스탬프 디렉터리를 가리키게 한다.- 컨테이너 런타임에게 "호스트의 이 경로를 컨테이너의 mountPath로 마운트하라"고 지시하면, 런타임은 이
..data심볼릭 링크를 컨테이너에 바인드 마운트한다.
즉 컨테이너에 실제로 마운트되는 건 원본 디렉터리가 아니라 ..data라는 심볼릭 링크다. 그래서 ConfigMap·Secret이 업데이트되면 kubelet은 새 타임스탬프 디렉터리를 만들어 새 데이터를 쓴 다음, ..data가 가리키는 대상만 원자적으로 바꿔치기한다. 파일 내용을 직접 덮어쓰는 게 아니라 링크가 가리키는 대상을 통째로 스왑하는 방식이라, 애플리케이션이 파일을 읽는 도중에 절반만 갱신된 내용을 보는 일이 없다.
5. 이 환경 변수는 프로세스 메모리 어디에 있을까
여기까지 오니 하나 더 궁금해졌다. execve()가 각인해준다는 그 환경 변수, 프로세스 메모리 안에서 정확히 어디에 앉아 있을까. 결론부터 말하면 Stack 세그먼트 바로 위, 가상 메모리에서 가장 높은 주소 영역이다.
+------------------------+ <-- Highest Memory Address
| Kernel Space           | (프로세스에서 직접 접근 불가)
+------------------------+
|                        |
| Environment Variables  |
| Command-line Arguments |
+------------------------+
| Stack (스택)            | (아래 방향으로 자람)
|      ↓                 |
+------------------------+
|                        |
| (Unmapped Memory)      |
|                        |
+------------------------+
|      ↑                 |
| Heap (힙)              | (위 방향으로 자람)
+------------------------+
| BSS Segment            |
+------------------------+
| Data Segment           |
+------------------------+
| Text Segment (Code)    |
+------------------------+ <-- Lowest Memory Address
| (Reserved)             |
+------------------------+
컨테이너의 본질이 프로세스이니 이 구조도 그대로 따라간다. 그런데 왜 하필 Stack 위일까. Text·Data·BSS 사이나 Heap 아래에 둬도 될 것 같은데 말이다.
먼저 Text·Data·BSS 사이에 두지 않는 이유는 프로세스 생성이 복잡해지고 느려지기 때문이다. 커널 로더가 execve를 처리할 때 디스크의 Text·Data 세그먼트를 mmap()으로 가상 메모리에 거의 그대로 매핑하는데, 이건 파일의 연속된 바이트가 메모리에서도 연속되는 굉장히 빠른 작업이다. 만약 Text와 Data 사이에 가변 크기인 환경 변수 블록을 끼워 넣는다면, 커널은 Text를 매핑하고, 환경 변수 크기를 계산하고, 그만큼 빈 공간을 확보하고, 그 다음에 Data를 매핑하는 식으로 훨씬 복잡한 절차를 거쳐야 한다. 게다가 Text·Data 사이 거리가 실행마다 달라져서 디버깅과 프로파일링도 어려워진다. 여기에 더해 Text는 보통 읽기·실행(r-x), Data·BSS는 읽기·쓰기(rw-) 권한을 갖는데, 세그먼트 사이에 다른 데이터를 끼워 넣으면 페이지 단위로 권한을 관리하는 MMU 설정까지 복잡해진다.
그럼 BSS와 Heap 사이는 어떨까. Text·Data·BSS는 컴파일·링크 시점에 크기가 정해지고, 정적 데이터 영역이 끝나는 주소를 _end(또는 __bss_end__) 심볼로 실행 파일 안에 박아둔다. libc의 malloc 구현은 커널에 물어볼 필요 없이 이 _end 심볼만 읽으면 힙의 시작점을 알 수 있다. 그런데 만약 BSS와 Heap 사이에 크기가 매번 달라지는 ENV가 끼어든다면, malloc이 힙 시작점을 알기 위해 반드시 커널과 통신해야 하는 상황이 생긴다. 커널이 execve 결과로 새 힙 시작 주소를 넘겨주거나, libc가 별도 시스템 콜로 물어봐야 한다는 뜻이다. 이렇게 되면 커널과 libc 사이에 새로운 의존성이 생기고, 커널은 유저 스페이스 라이브러리인 malloc의 구현 방식까지 신경 써야 하니 시스템 복잡도만 올라간다.
반면 Stack은 사정이 다르다. Stack은 CPU(하드웨어)와 커널이 직접 관리하는 영역이라 ESP·RSP 레지스터 하나로 관리된다. execve 시점에 커널이 환경 변수와 인자를 스택 최상단에 쌓고, 최종 주소를 RSP 레지스터에 딱 한 번 설정해주면 끝이다. 이후로는 call, ret, push, pop 같은 기계어 명령어에 의해 RSP가 하드웨어 레벨에서 알아서 오르내린다. 유저 스페이스 라이브러리가 스택 시작점을 따로 알 필요가 없다. 반면 Heap은 관리 주체가 libc라는 순수 소프트웨어이고, malloc·free가 자체 자료구조(free list, bins 등)를 초기화하려면 반드시 고정된 기준점(_end 심볼)이 필요하다.
정리하면, Stack은 커널이 CPU 레지스터에 초기값 한 번 찍어주면 끝나지만, Heap은 소프트웨어(libc)가 자기 관리 체계를 시작하기 위한 고정 기준점이 필요하다는 근본적인 차이가 있다. 그래서 크기가 가변적인 ENV는 하드웨어가 알아서 관리해주는 Stack 바로 위에 얹는 게 가장 단순하고 효율적인 선택이 된 것이다.
6. Secret은 왜 굳이 base64로 인코딩되어 있을까
마지막으로 하나 더. Secret의 data 필드는 base64로 인코딩돼 있는데, 이걸 처음 보면 '이게 뭔가 암호화되어 있는 건가' 싶을 수 있다. 결론부터 말하면 base64 인코딩은 보안과는 아무 상관이 없다.
Secret의 data 필드는 임의의 바이너리 데이터를 담을 수 있게 설계됐다. 그런데 YAML·JSON 매니페스트는 기본적으로 Text 기반이라, 줄바꿈이나 null 문자(\0) 같은 제어 문자가 섞인 바이너리 데이터(예: id_rsa 개인키, .p12 인증서)를 그대로 넣으면 파싱 오류가 나거나 데이터가 깨질 수 있다. 그래서 모든 바이너리 데이터를 ASCII로 안전하게 변환하는 base64를 쓴 것이다. 변환된 문자열은 YAML·JSON에 아무 문제 없이 들어간다.
그럼 왜 기본적으로 암호화까지는 안 해줄까. 쿠버네티스가 확장 가능성을 핵심 설계 원칙으로 삼고 있기 때문이다. 만약 쿠버네티스가 특정 암호화 방식을 내장해서 강제했다면, 사용자들은 자기 환경에 맞는 KMS를 도입하는 데 큰 제약을 받았을 것이다. 대신 쿠버네티스는 Encryption at Rest라는 플러그형 메커니즘만 제공하고, 사용자가 자기 환경에 맞는 KMS Provider를 골라 API Server와 연동하도록 열어뒀다. 특정 기술에 종속되지 않으면서도 원하는 만큼 강력한 보안을 붙일 수 있게 설계한 셈이다.
끝
- ConfigMap과 Secret은 Pod 입장에서는 사용법이 비슷해 보이지만, 나뉜 이유는 순전히 RBAC 접근 제어와 외부 시스템 연동을 위한 설계 결정이다.
- env 방식이 불변인 건 쿠버네티스 정책이 아니라
execve()가 프로세스를 초기화하는 순간 커널이 스택 위에 값을 딱 한 번 찍어주고 끝나기 때문이다. - volumeMount 방식이 Hot Reload되는 비밀은 파일을 직접 덮어쓰는 게 아니라
..data심볼릭 링크가 가리키는 대상을 원자적으로 바꿔치기하는 데 있다. - Secret이 base64인 건 암호화가 아니라 바이너리 데이터를 YAML·JSON에 안전하게 넣기 위한 인코딩일 뿐이다. 진짜 보안은 Encryption at Rest와 RBAC 조합으로 챙겨야 한다.
- ConfigMap은 1MiB 제한이 있으니, 그보다 큰 설정은 볼륨 마운트나 별도 DB·파일 서비스를 쓰는 걸 고려하자.